当AI工厂的单机架功率密度持续攀升,传统“先建后调”的数据中心交付模式正面临越来越大的不确定性。施耐德电气、Nscale与Start Campus在葡萄牙SINES园区完成的端到端数字孪生试点,尝试用一套统一模型把AI负载需求与电力、冷却、电气及运营系统连接起来,让配置变更在上线前先经过仿真验证。J9九游会关注这一案例的技术路径与落地条件。
该试点基于NVIDIA Omniverse DSX蓝图构建,属于NVIDIA DSX Sim的一部分,整合了施耐德电气、AVEVA与ETAP的技术能力。其核心目标并非展示概念,而是让运营方Nscale在SIN01数据中心内,对新增硬件代际和系统调整进行“假设”推演,以缩短部署周期并降低现场变更风险。
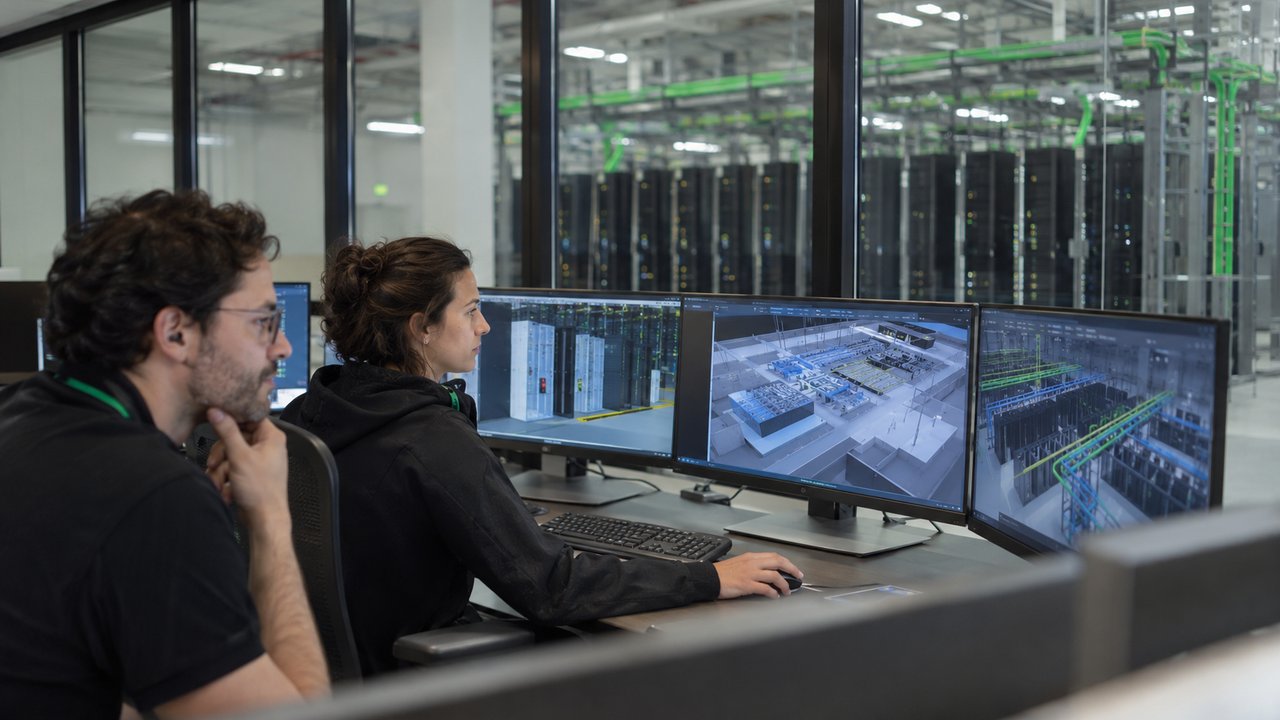
统一模型:把AI负载与基础设施放进同一张图
AI工厂的复杂性在于,GPU负载的波动会同时传导至供配电、液冷回路和运营调度。传统模式下,这些系统往往由不同团队使用不同工具分别建模,信息割裂导致变更评估滞后。此次试点的关键做法,是构建基于OpenUSD的数字孪生,将施耐德电气、ETAP、AVEVA及第三方技术的数据接入同一平台。
在这一模型中,Nscale的AI工作负载需求与Start Campus的物理设施数据形成对应关系。运营方可以在虚拟环境中测试机架密度跃升对电力链和冷却回路的影响,而不必先进行物理改造。这种“先仿真、后施工”的顺序,有助于把配置决策提前到采购和部署之前。
试点现场:SINES园区的真实约束与验证目标
试点落地于Start Campus开发的SINES数据园区,该园区位于葡萄牙,规划容量1.2 GW,SIN01是其中正在运营的数据中心。资料显示,该园区设计上支持多代AI基础设施,并将容纳超过66,000块NVIDIA Rubin GPU。这一规模意味着电力、冷却和空间约束都极为具体,数字孪生需要面对的是真实工程条件,而非理想化假设。
Nscale作为运营方,期望借助数字孪生实现更快的token产出时间、更高的token效率、更优的运营表现,以及在技术栈更新时更强的灵活性和更低风险。需要明确的是,这些是试点预期目标,而非已经兑现的收益。数字孪生的价值在于把“可能在哪里优化”识别出来,最终效果仍取决于现场实施和持续调优。
全生命周期覆盖:从设计验证到运营优化
该试点覆盖AI工厂从设计到运营的完整生命周期。在设计阶段,团队可以对电力、冷却和工艺行为进行快速“假设”场景测试,验证设计决策并评估升级影响;在采购阶段,仿真结果可用于降低选型风险;在运营阶段,通过连接IT与OT数据,持续识别性能优化空间。
另一个值得关注的细节是“仿真就绪”的资产文件。数字孪生要真正可用,前提是设备模型、参数和接口能够被平台直接读取和计算。试点推进这类资产文件的互操作性,实际上是在为后续规模化复制降低集成成本。没有这一步,数字孪生容易停留在可视化层面,难以支撑工程决策。
协作模式与行业参考:数字孪生落地需要哪些条件
从参与方分工看,Start Campus提供物理设施、工程经验和运营环境,Nscale提供AI负载与IT基础设施需求,施耐德电气、AVEVA和ETAP提供数字孪生与仿真软件能力,NVIDIA提供Omniverse DSX蓝图及仿真库。这种跨能源管理、工程仿真和AI运营的协作,是端到端模型能够成立的组织前提。
评估此类方案时,读者可关注几个落地条件:一是设施数据是否完整且可被模型调用;二是IT与OT数据能否持续同步,而非一次性导入;三是仿真结果是否与实际运行形成闭环校验;四是资产文件是否具备可移植性,避免绑定单一平台。这些条件决定了数字孪生是项目级演示,还是可复用的运营工具。
从行业角度看,施耐德电气、AVEVA与ETAP此前已加入OpenUSD联盟,并持续围绕参考架构和集成基础设施展开合作。此次试点可视为把既有软件能力放入真实AI工厂环境的一次检验。它不意味着规模商用已经完成,但为高密度AI数据中心提供了一种可讨论的方法:在物理变更之前,先用统一模型把电力、冷却和负载的相互作用算清楚。J9九游会将持续关注后续运营数据的验证情况。
对于正在规划或扩容AI工厂的运营方而言,这一试点的启示不在于某一款产品,而在于交付流程的调整:把数字孪生从设计辅助工具提升为连接采购、部署和运营的决策底座。其实际成效仍需观察SIN01后续运行数据,但“先仿真、再建设”的思路,已成为高密度AI基础设施值得认真评估的工程选项。